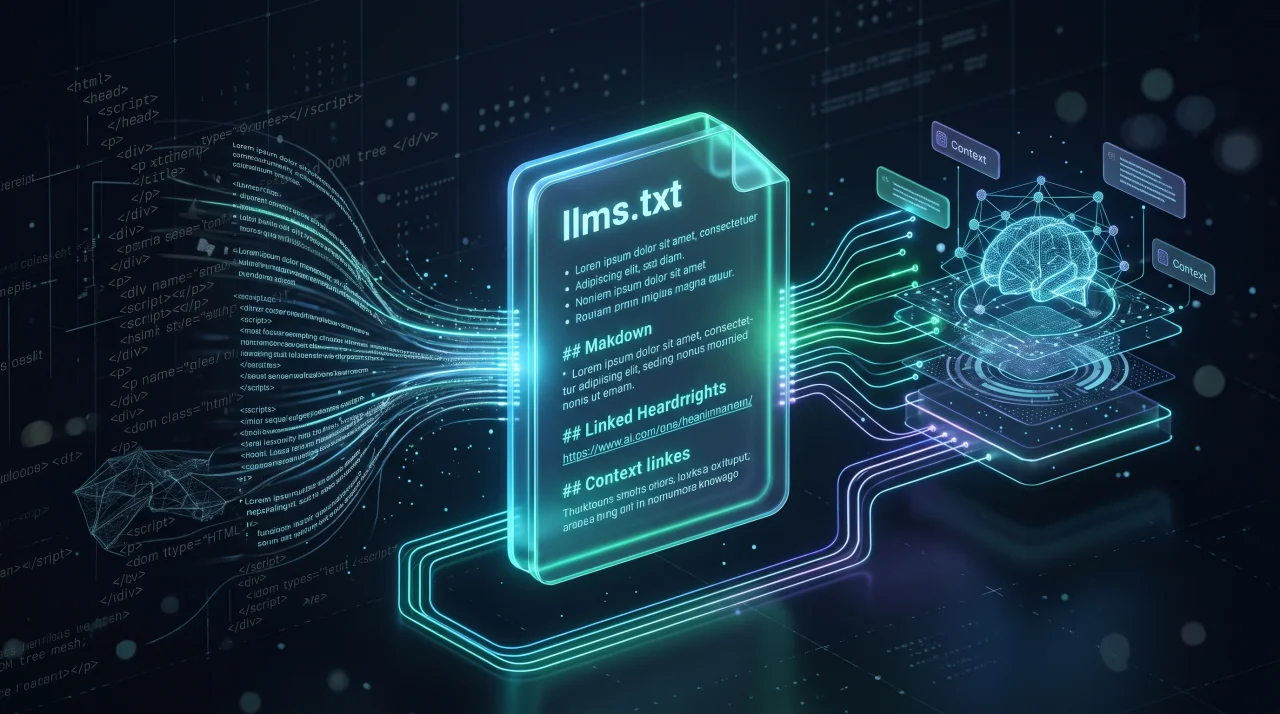
Arama motoru botları (crawler) HTML DOM ağaçlarını, JavaScript kodlarını ve CSS yapılarını analiz etmek üzere tasarlandı. Ancak büyük dil modelleri (LLM) ve otonom yapay zeka ajanları (AI agents) bu karmaşık web yığınıyla ilgilenmiyor; doğrudan, temiz ve yapılandırılmış saf veriye ihtiyaç duyuyor. HTML sayfalarının bilgi yığınını navigasyon, reklam ve JavaScript kodlarıyla sarmalaması nedeniyle ortaya çıkan llms.txt dosyası, yapay zeka sistemlerine doğrudan bir web sitesi kılavuzu sunar.
1. llms.txt Standardı Nedir ve Nasıl Doğdu?
llms.txt, bir web sitesinin ana dizininde (root) barındırılan ve yapay zeka ajanlarına sitenin özetini sunarak yararlı bağlantıları listeleyen standartlaştırılmış formatında bir dosyadır.
Bu mimari yapı, Fast.ai ve Answer.AI kurucu ortağı Jeremy Howard tarafından 3 Eylül 2024 tarihinde yayımlandı. W3C veya IETF gibi resmi kurumlar tarafından standartlaştırılmış bir internet protokolü olmamasına rağmen, geliştirici toplulukları tarafından hızla bir standart teklifi olarak kabul görmüştür.
2. Sürüm Geçmişi: v1 ve v2 Arasındaki Mimari Farklar
Yapay zeka modellerinin bağlam kapasitelerinin genişlemesi ve kodlama ajanlarının bu standartları aktif olarak kullanmaya başlamasıyla birlikte mimaride kapsamlı bir güncellemeye gidildi.
v1 Sürümü (Eylül 2024)
İlk teklif, LLM tabanlı ajanların web sitelerini tarayabileceği fikrinin henüz deneysel aşamada olduğu bir dönemde hazırlandı. Modellerin daha kısıtlı bağlam (context) pencerelerine sahip olduğu bu dönemde, sistemdeki ayrıştırıcı araçların mekanik olarak bazı bölümleri atlayabilmesi için Optional (İsteğe Bağlı) bölümler özel ve katı kurallara sahipti.
v2 Sürümü (Ağustos 2026)
Binlerce sitenin, otonom yazılım ajanlarının ve dokümantasyon platformlarının standardı aktif olarak benimsemesi üzerine Ağustos 2026'da v2 sürümü yayımlandı. Bu güncellemeyle birlikte şu değişiklikler uygulandı:
- Esneklik: "Optional" (İsteğe Bağlı) bölümünün mekanik kısıtlayıcılığı kaldırılarak sistemdeki botları zorlamak yerine sadece faydalı bir başlık düzeni (heading convention) haline getirildi.
- Yönlendirici Odaklılık: Standart, dosyaları işleyip birleştiren eski
llms_txt2ctxaracını kullanımdan kaldırarakllms.txtdosyasını yalnızca bir yönlendirici (pointer) olacak şekilde sadeleştirdi.
3. Kullanım Amaçlarına Göre Dosya Hiyerarşisi
Bu dosya yapısı farklı kullanım senaryolarına hizmet eder ve yapay zekanın sitenizle etkileşim biçimini belirler.
Dizin Haritası Olarak: llms.txt
Modelin sitenin ne hakkında olduğunu anladığı ana indeks dosyasıdır. Sitenin kök dizininde veya bir alt dizinde konumlandırılabilir.
- Standart gereği dosya, site veya projenin adını taşıyan zorunlu bir H1 başlığı ile başlamak zorundadır.
- Başlıktan hemen sonra projenin anlaşılması için kritik öneme sahip kısa bir blok alıntı (blockquote) özeti yer almalıdır.
- Açıklamaların ardından, detaylı bilgilerin yer aldığı dosyalara yönlendirme yapan URL listeleri gelir.
Tek Parça Bağlam Katmanı Olarak: llms-full.txt
llms-full.txt, isteğe bağlı bağlantılar ve detaylı içeriklerin tek bir dosyada birleştirilmiş halidir. RAG (Retrieval-Augmented Generation) sistemleri ve otonom kodlama ajanları, sitenizdeki onlarca sayfayı ayrı ayrı taramak yerine bu tek dosya üzerinden sitenizin tüm teknik birikimini kendi belleğine yükler.
4. LLM Optimizasyonu (GEO) ve Klasik SEO İlişkisi
Arama motoru optimizasyonu süreçlerinde klasik SEO kuralları ile yapay zeka ajan optimizasyonunu birbirinden ayırmak gerekir. Google, "Yapay Zeka Özellikleri" kılavuzunda llms.txt gibi özel AI metin dosyalarının Google arama sonuçlarına doğrudan bir katkısı veya zararı olmayacağını belirtmektedir.
Ancak otonom yazılım ajanları, özel GPT'ler ve veri madenciliği botları, robots.txt protokolüne uyarak izne tabi dizinlerdeki llms.txt yönlendirmelerini okur. Sitenizi HTML içindeki DOM karmaşasından ve yapılandırılmamış (unstructured) veri kirliliğinden arındırarak saf metin formatında sunmak, büyük dil modellerinin projeniz hakkında ürettiği içeriklerde halüsinasyon (hallucination) riskini en aza indirir ve doğrudan teknik doğruluğu garanti altına alır.